Saúde do SSD no Proxmox: desgaste, TBW e SMART
Como ler o desgaste do SSD no Proxmox com smartctl: Percentage Used, Data Units Written, a conta do TBW e o aviso do smartd que já vem ligado no host.
- Publicado
- Leitura
- 5 min
- Testado em
- Proxmox VE 9.2
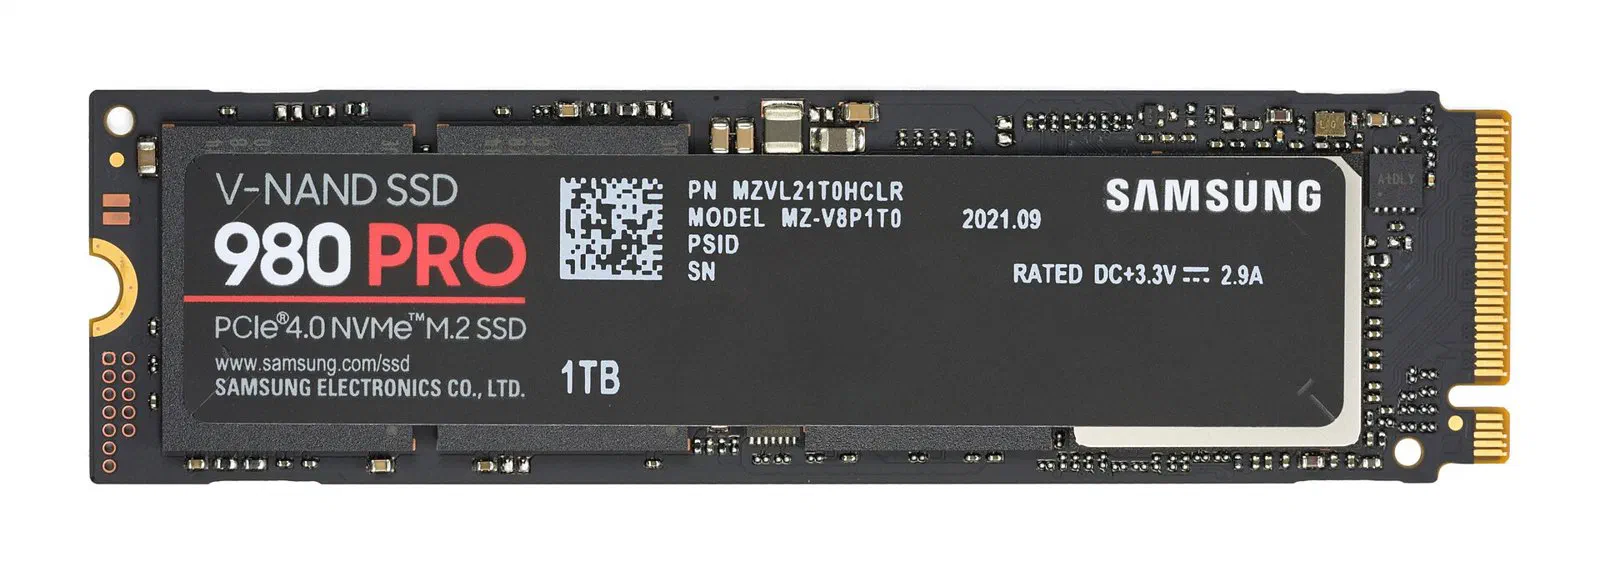
O SSD do meu homelab guarda tudo: o sistema do Proxmox e todos os containers. É um disco de 1 TB num ThinkCentre M720q. E eu já perdi um SSD junto com o HD de backup, como conto no post sobre backup com vzdump. Desde então, quero saber antes quando um disco está chegando no fim.
SSD não morre só de repente. Ele se desgasta com as gravações, e o próprio disco conta quanto já gastou. Neste post explico como ler isso no Proxmox, o que significa TBW e o que eu olho para decidir a troca.
Por que um SSD se desgasta #
As células de memória flash aguentam um número limitado de ciclos de gravação e apagamento. O controlador do SSD espalha as gravações pelo disco para gastar tudo por igual, mas o limite existe.
Para dizer quanto o disco aguenta, os fabricantes usam o TBW (terabytes gravados). É o total de dados que dá para gravar dentro da garantia. Um exemplo de ficha técnica: pela ficha técnica, o Kingston NV3 de 1 TB tem 320 TBW. Modelos de outras linhas e marcas têm números bem diferentes, então vale olhar a ficha do seu.
Num homelab, o que grava no SSD o tempo todo é:
- log dos containers e do próprio Proxmox;
- bancos de dados dos apps;
- os backups, se o destino estiver no mesmo SSD;
- swap, se a memória apertar.
O que o Proxmox já traz #
Pela documentação oficial, o Proxmox VE instala o smartmontools desde a versão 4.3. É o conjunto de ferramentas que lê o S.M.A.R.T., o relatório de saúde que o próprio disco mantém.
Mais importante: o smartd vem ativo. A documentação diz que ele verifica os discos (incluindo os NVMe, /dev/nvme0 em diante) a cada 30 minutos e manda um e-mail para o root se encontrar um problema. Se o e-mail do root não chega a lugar nenhum, esse aviso se perde. Vale conferir para onde vão os e-mails do host.
Lendo a saúde do disco #
No shell do host, o comando é:
smartctl -a /dev/nvme0
Para um SSD SATA, troque pelo caminho dele, como /dev/sda. Num NVMe, três linhas contam quase tudo:
- Percentage Used: a estimativa do fabricante de quanto da vida útil já foi usada. Começa em 0. Em 100, a resistência estimada acabou, o que não quer dizer que o disco falhou. O valor pode passar de 100.
- Data Units Written: quanto já foi gravado. A unidade é estranha: cada unidade vale mil blocos de 512 bytes, ou seja, 512.000 bytes.
- Available Spare: a reserva de células para substituir as que se gastam. Quando cai abaixo do limite (Available Spare Threshold), é hora de trocar.
A conta para transformar as unidades em terabytes é simples:
# troque 12345678 pelo valor de Data Units Written
echo "12345678 * 512000 / 10^12" | bc -l
O resultado é o total gravado, em TB. Compare com o TBW da ficha técnica e você sabe quanto da garantia já usou.
Na interface web também dá para ver: o Proxmox mostra os valores S.M.A.R.T. na lista de discos do nó.
O que fazer se o desgaste estiver alto #
Se a conta mostrar que o SSD grava mais do que deveria, há alguns caminhos:
- Descobrir quem grava. Container com log muito falante ou banco de dados mal configurado costuma ser o culpado.
- Tirar o backup do SSD. O destino do vzdump deve ficar em outro disco. Aqui, vai para um HD externo USB, e uma cópia vai para fora de casa.
- Evitar swap constante. Se a memória está no limite, o sistema grava no disco o tempo todo. Mais memória está na minha lista de compras.
- Escolher bem o próximo disco. A documentação do ZFS no Proxmox recomenda SSDs com proteção contra queda de energia para os discos de log e cache, porque têm latência de gravação bem menor. Para ZFS, eu olharia modelos com TBW alto. Comparo ZFS e LVM-thin no post ZFS ou LVM-thin no Proxmox.
Minha rotina #
No meu Proxmox, quem acompanha o SSD é um script meu, o pve-health.sh. Ele monitora a saúde do host inteiro, e o SSD entra nessa conta. É por ele que eu fico de olho no disco.
Com ou sem um script assim, o roteiro vale para qualquer homelab:
- Rodar o
smartctl -ano SSD e no HD de backup e anotar os valores, para ter um ponto de partida. - Conferir se os e-mails do root saem do host, para o aviso do smartd chegar.
- Repetir a leitura todo mês e comparar.
- Planejar a troca quando o Percentage Used passar de uns 80%, ou antes, se o Available Spare começar a cair.
Resumindo #
- SSD se desgasta com as gravações. O TBW da ficha técnica diz quanto ele aguenta.
- O Proxmox já traz o smartmontools, e o smartd avisa o root por e-mail a cada 30 minutos se achar problema.
smartctl -amostra Percentage Used, Data Units Written e Available Spare.- Cada Data Unit vale 512.000 bytes. Multiplique para saber quantos TB já foram gravados.
- Backup fora do SSD e pouca swap ajudam o disco a durar mais.
Perdi um SSD sem aviso uma vez. Agora o pve-health.sh fica de olho nele, e eu sei quando estiver chegando perto do fim.